可以——分镜脚本不用再逐格手填:在 Shotshot 里发一句话,Agent 会自动创建脚本节点、拆好分镜、建齐角色场景道具资产、连好生成节点;后续改运镜、加镜头、调顺序,也都是对话里一句话的事。它和 LibTV 的脚本节点解决同一个问题——把「写分镜」从文档搬进节点画布——但走的是另一条路:Agent 代写、模型 BYOK、数据留在本地桌面端。这篇文章用一条 15 秒保温杯广告片的真实生成过程,拆开 Shotshot 脚本节点的能力,并和 LibTV 的脚本工作流做一次诚实对比。
脚本节点是什么:把分镜从文档变成结构化数据
LibTV 是 LiblibAI 在 2026 年 3 月推出的 AI 视频创作平台,核心思路是「无限画布 + 节点式工作流」:文本、图片、视频、音频、脚本五种节点连线成流程,脚本节点输入剧情或角色设定就能自动生成分镜,再批量转分镜图、转视频片段。这个方向验证了一件事:分镜是 AI 视频创作里最值得结构化的一环。
Shotshot 的脚本节点走的是同一语义、不同分工。它不只是一次性的「生成结果」,而是一份持续可编辑的结构化分镜数据:
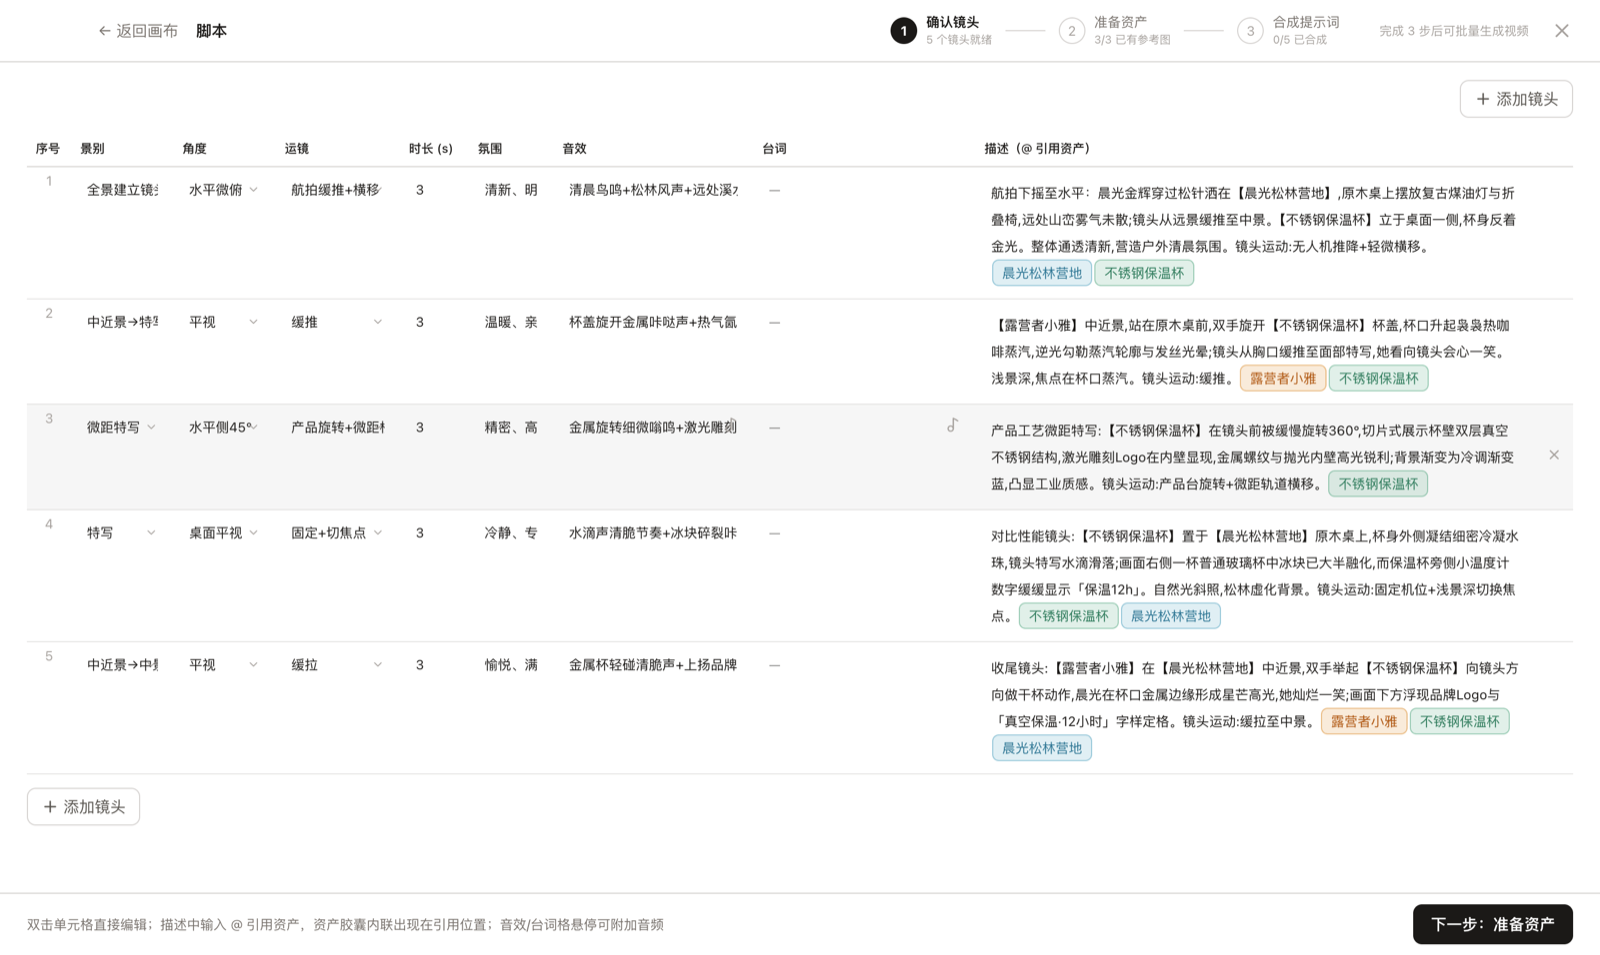
- 九字段分镜表:序号、景别、角度、运镜、时长、氛围、音效、台词、描述,双击即改;描述里可以 @ 引用资产,被引用的资产以彩色胶囊内联出现。
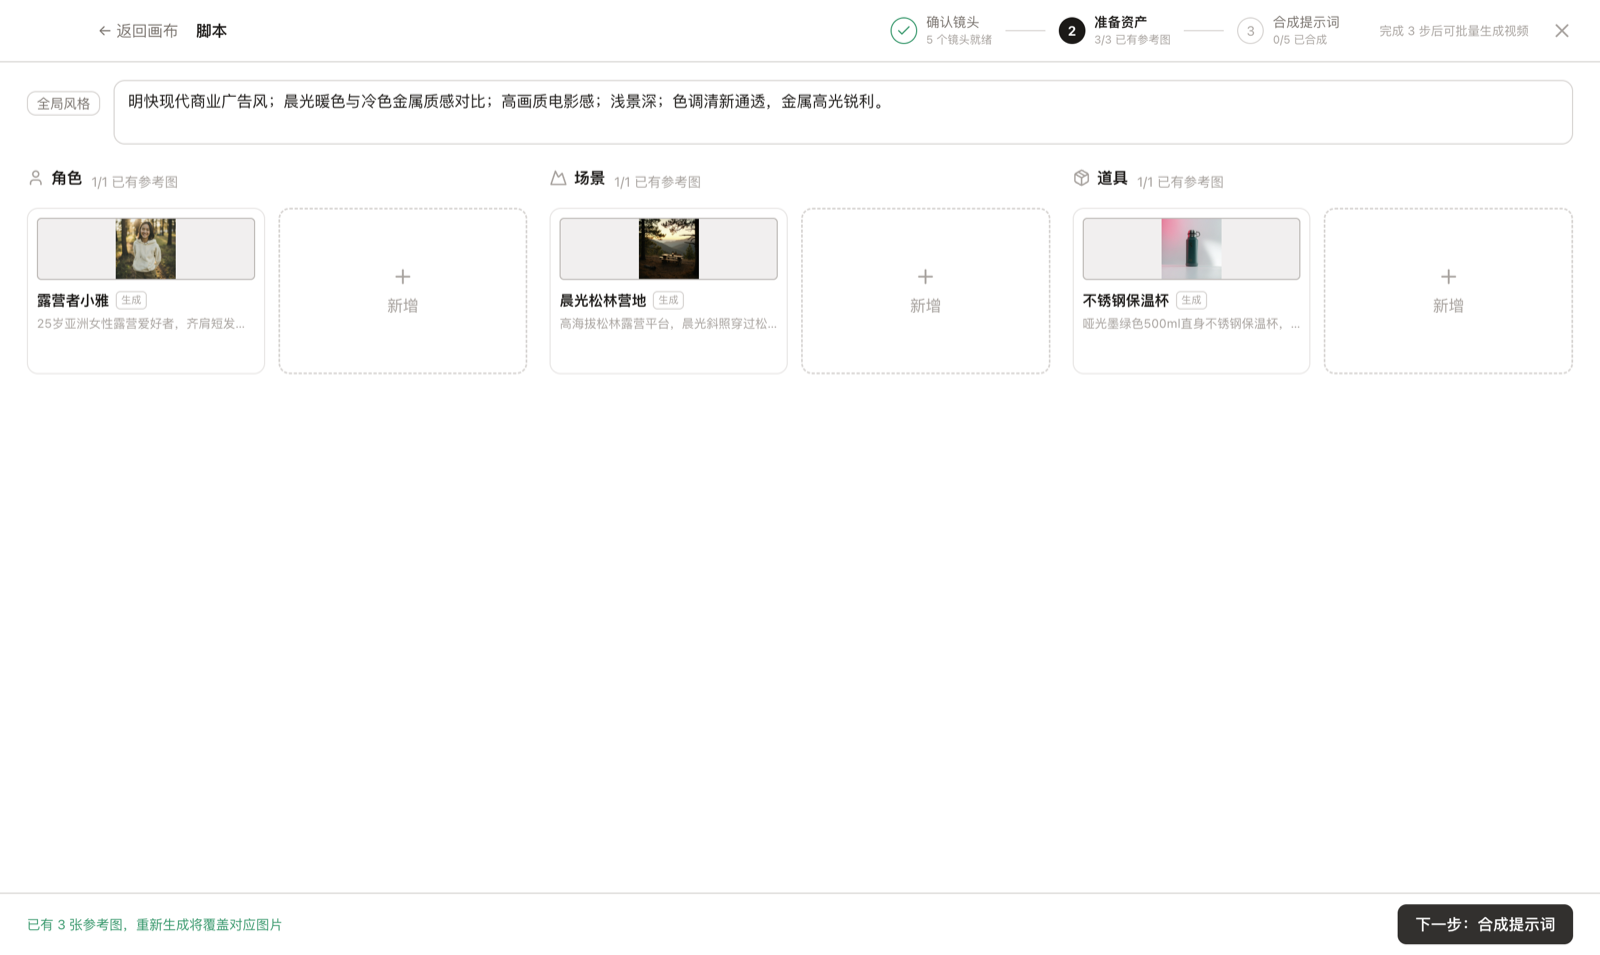
- 资产一致性管理:角色、场景、道具三类资产各有定位、定义、一致性与参考图;参考图可以生成、从画布选、从资产库选,生成完成自动回写。
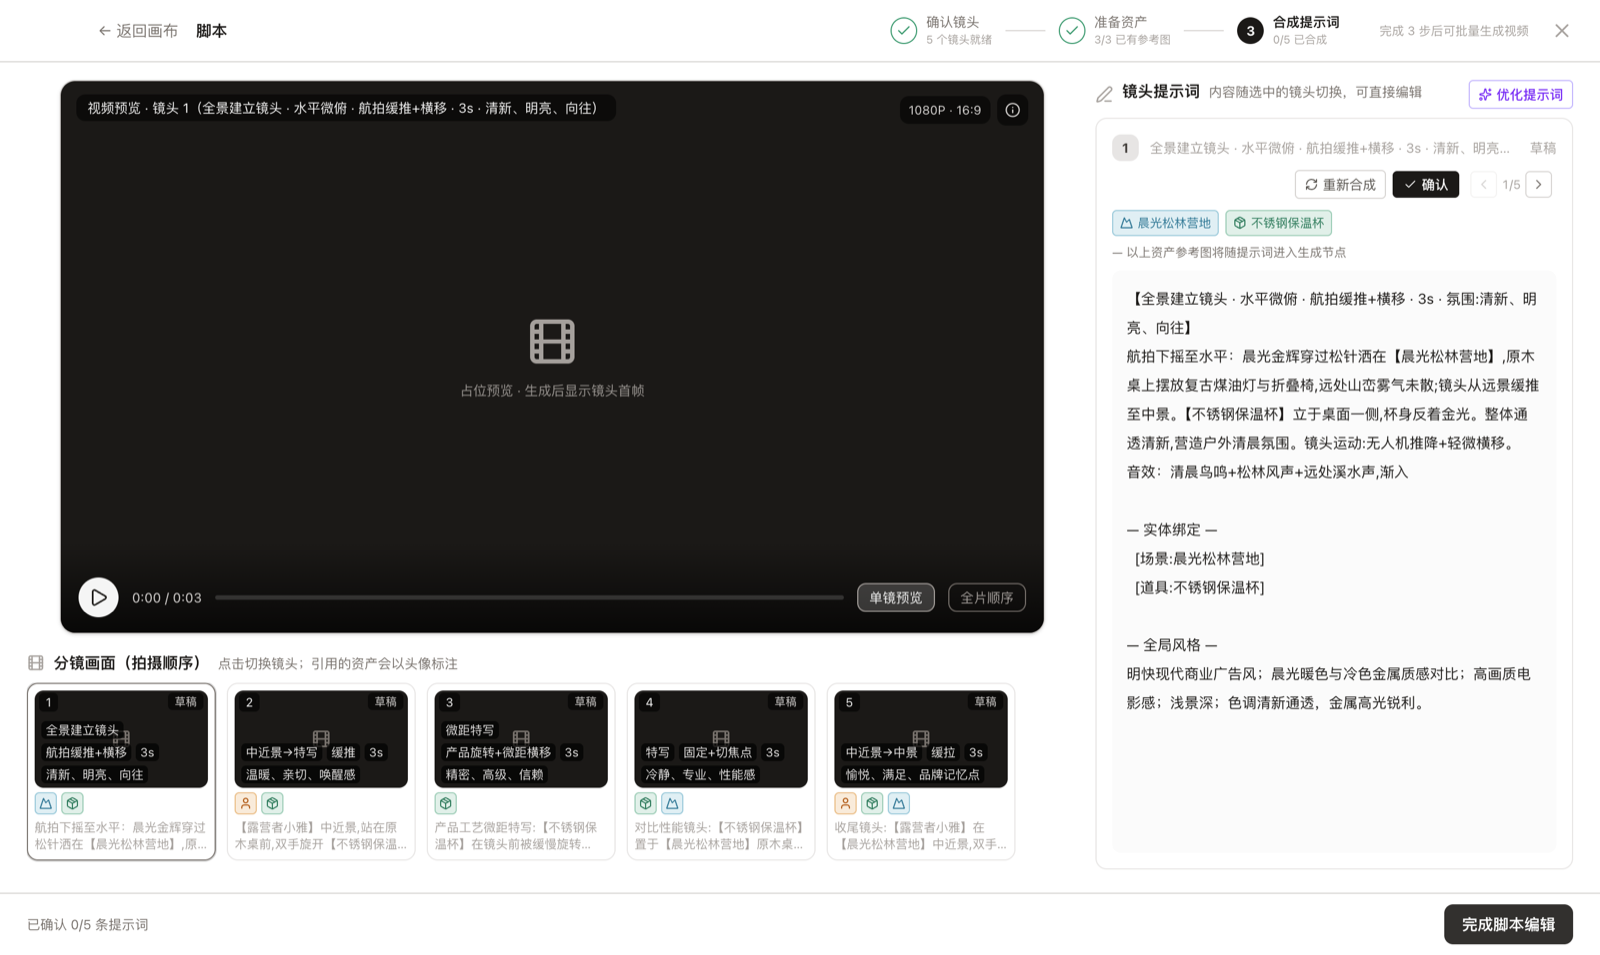
- 逐镜提示词合成:把景别、运镜、时长、氛围、音效、台词、资产绑定和全局风格拼装成每条镜头的最终提示词(finalPrompt),供视频生成节点直接使用。
- 一键展开成视频节点:确认脚本后,每条分镜展开为一个视频生成节点,参考图与音频连线自动接好,随后逐个或批量出片。
换句话说,脚本节点管「分镜这条数据」的生老病死,生成能力仍由画布上的图像、视频、音频节点承担——而谁来写、谁来改这份分镜,正是 Agent 登场的地方。
Agent 实测:一句话到六个镜头
为了让差异可验证,我们用一条真实需求走完全程:15 秒不锈钢保温杯产品广告,16:9 横屏,突出真空保温与材质工艺特写,户外露营场景,无台词只要音效。需求一次说全,Agent 直接开工。
第一步:Agent 建节点、写分镜、连资产
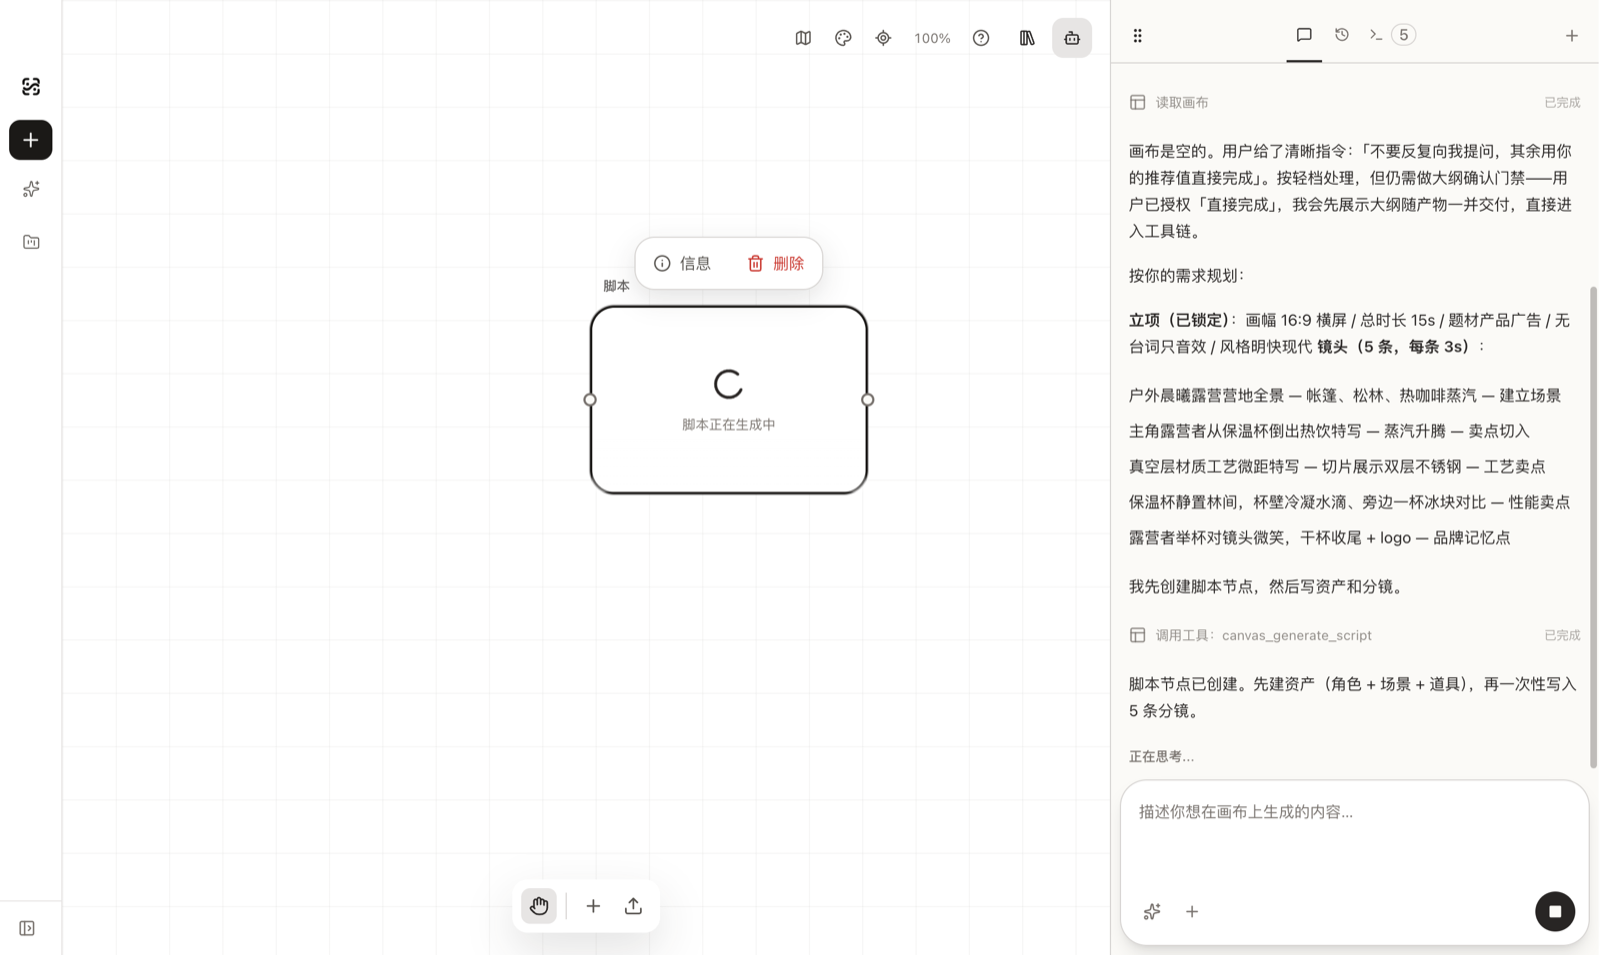
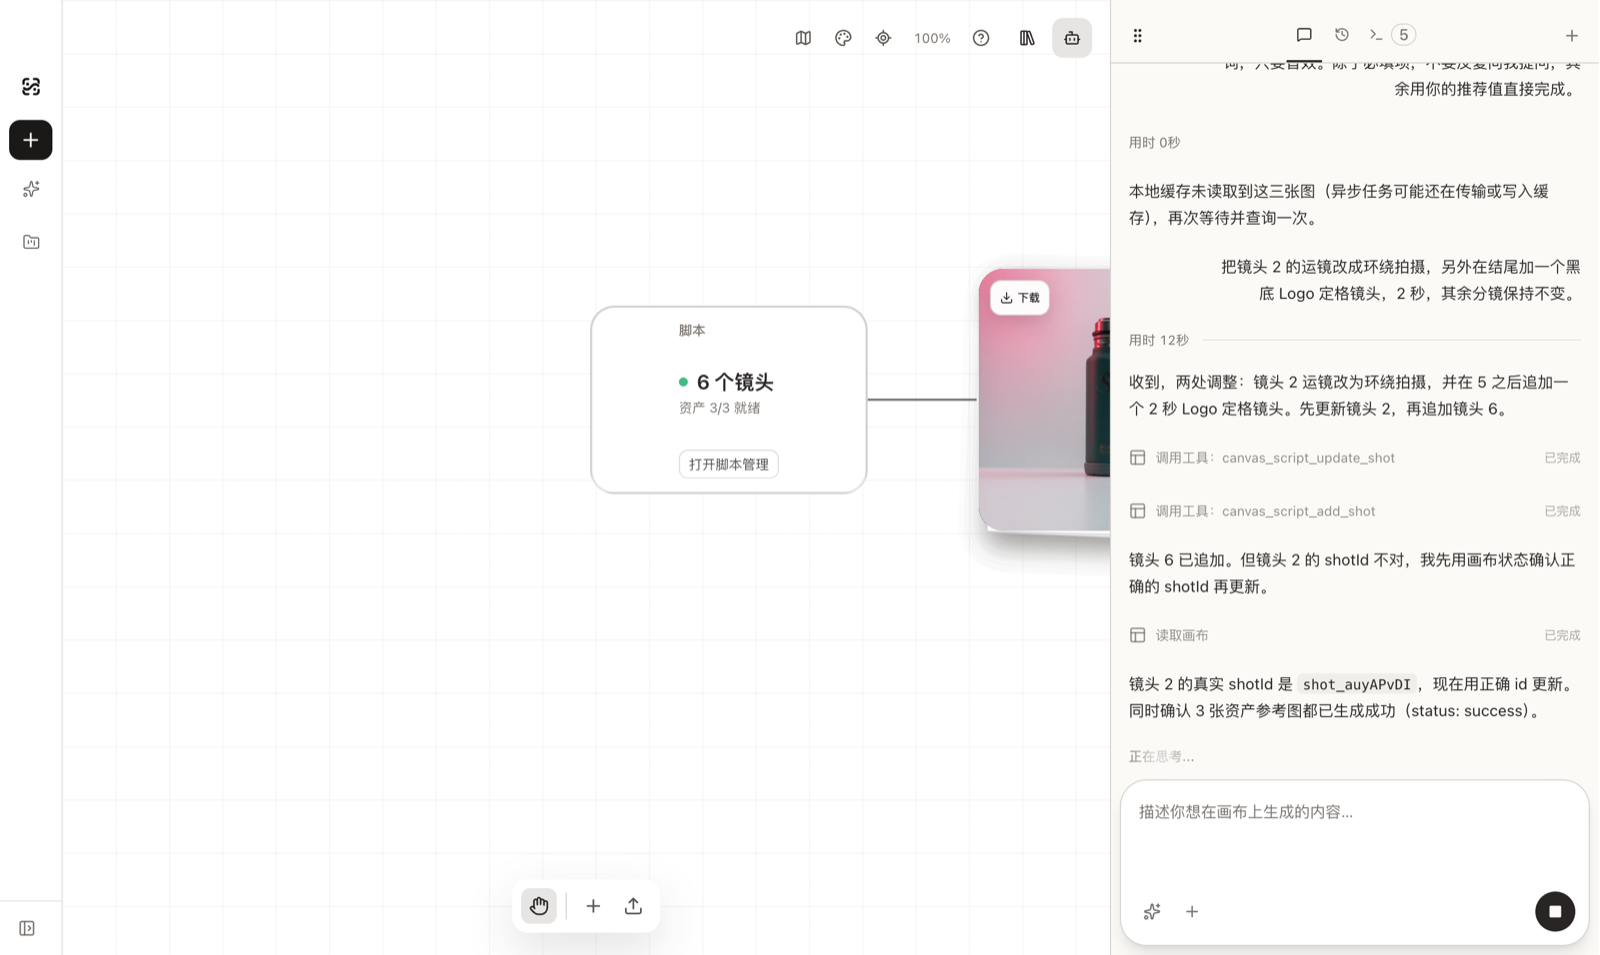
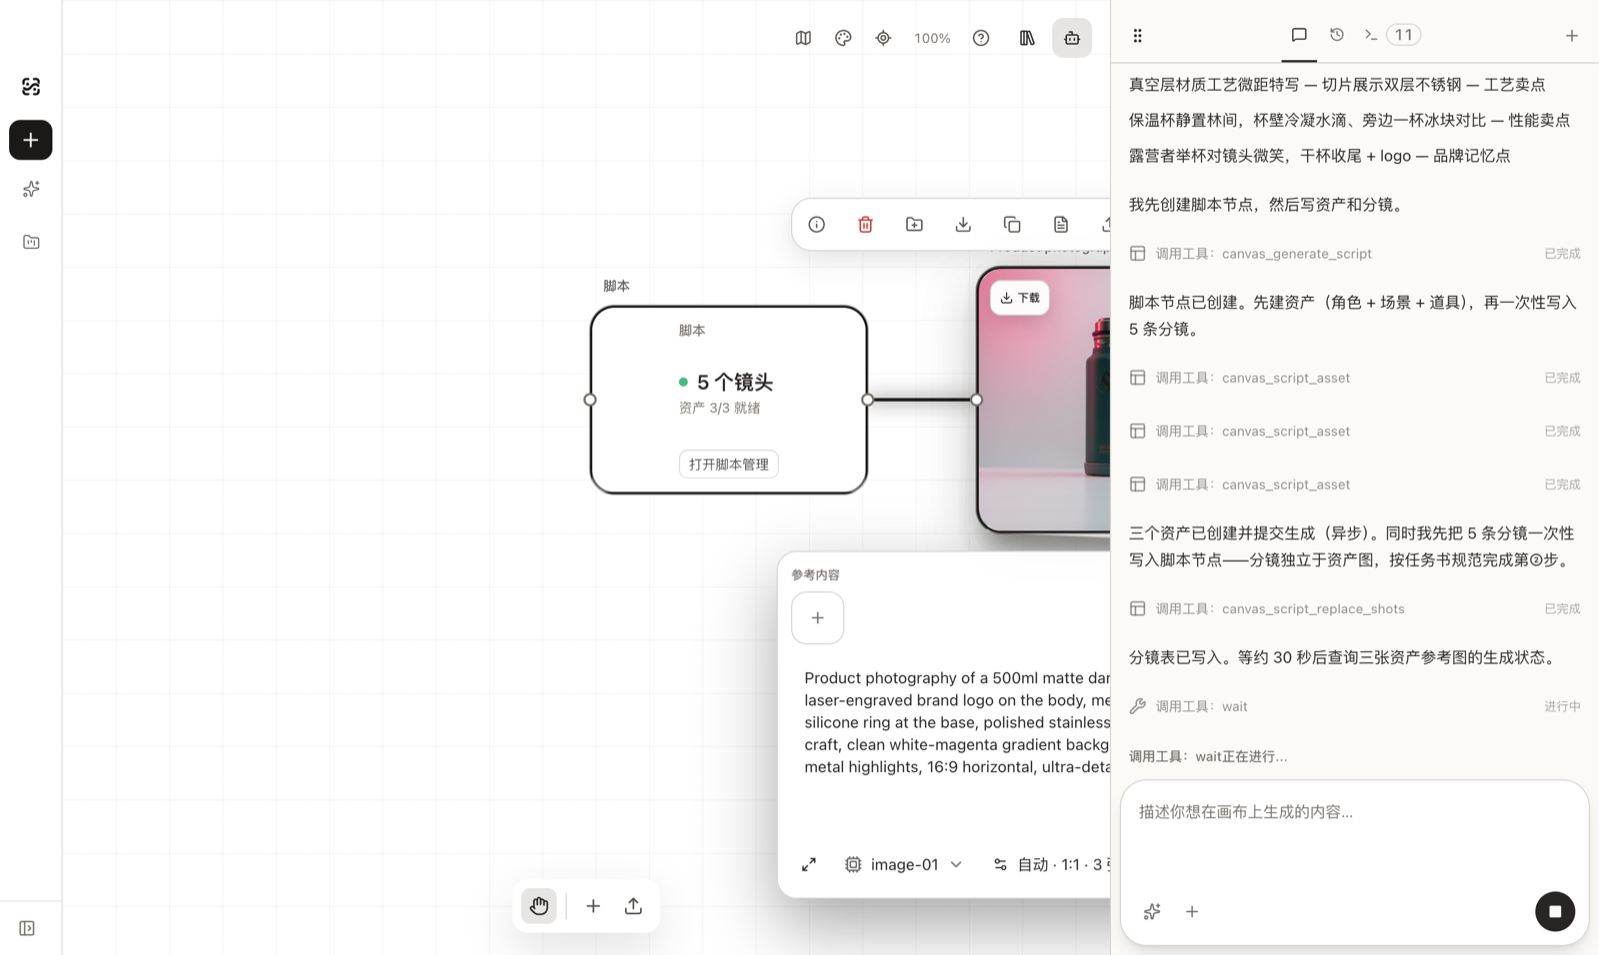
首页输入需求后,Agent 面板里能看到完整的工具调用链:先 canvas_generate_script 创建脚本节点,再 canvas_script_asset 依次创建露营者、营地场景、保温杯三个资产并接上图像生成节点,最后 canvas_script_replace_shots 把五条分镜一次性写入。画布上,脚本节点实时显示「5 个镜头、资产 3/3 就绪」。
生成过程中节点会先以「脚本正在生成中」的状态落位,分镜写入完成后自动就绪——这个过程你只需要看,不需要操作。
第二步:对话式修改,不是重新生成
分镜初稿出来后,真正的差异来了。我们对 Agent 说:「把镜头 2 的运镜改成环绕拍摄,另外在结尾加一个黑底 Logo 定格镜头,2 秒,其余分镜保持不变。」
Agent 没有重写整份脚本,而是调用 canvas_script_update_shot 精确改镜头 2 的运镜字段,再 canvas_script_add_shot 追加镜头 6。中途它发现传入的 shotId 不对,主动读取画布状态拿到正确 ID 后重试——节点计数从 5 变成 6,其余四条分镜原样未动。
除了改和增,脚本工具还覆盖删除单镜、整体重排、逐镜提示词编译等操作。分镜是结构化数据,Agent 的每次修改都是一次精确的字段级写入,而不是「重新抽一次卡」。
第三步:脚本管理工作台里人工精修
双击脚本节点进入三步工作台,可以人工接管任何细节:
- 确认镜头:九字段分镜表逐行检查、双击即改;
- 准备资产:三类资产的参考图与一致性设定,可生成、可替换;
- 合成提示词:逐镜预览 finalPrompt,点「优化提示词」会让 Agent 按导演技能规范再打磨一版。
人工编辑和 Agent 编辑操作的是同一份数据,随时可以来回接力:Agent 起稿、人精修、再让 Agent 批量微调,都是同一个循环。
和 LibTV 的脚本节点比:三种差异
截至 2026 年 9 月,两家脚本能力并排看:
| 维度 | LibTV 脚本节点 | Shotshot 脚本节点 + Agent |
|---|---|---|
| 分镜创建 | 表单/模板式:选脚本模式(剧本、角色、视频参考)一键生成分镜 | 对话式:一句话描述需求,Agent 规划镜头后写入结构化分镜表 |
| 分镜修改 | 手动编辑分镜内容,或换模式重新生成 | 对话式字段级增删改排(update/add/delete/reorder),也可手动编辑 |
| 运行位置 | 云端平台(浏览器访问) | 本地桌面应用(Windows/macOS/Linux),项目数据默认留在本机 |
| 模型接入 | 平台内集成模型(如 Seedance 系列),按平台额度计费 | BYOK:接入 OpenRouter、fal.ai、DeepSeek、Kimi、GLM 等自有渠道,账单出自你的服务商 |
| 数据边界 | 项目与素材存于平台云端 | 项目、素材、API Key 默认存本机,生成请求直连你配置的服务 |
| 生态 | 闭源平台,提供 OpenAPI 与外部 Agent 技能包 | 桌面客户端,Agent 工具链原生读写画布全部节点 |
结论:如果做影视叙事短片,想要模板化的一键分镜成片和平台内模型生态,LibTV 更顺手;如果分镜服务于产品——电商广告、众筹演示、未上市产品素材——需要自带参考图、自有模型 key 和本地数据边界,Shotshot 的组合更对口。两者不互斥,不少团队会按项目性质混用。
脚本节点把 Shotshot 在图片环节的可控性带进了视频:3D 参考图保形状、结构化分镜保节奏、BYOK 保预算与隐私。在 Shotshot 里,一条产品广告的分镜从来不是孤立文档——它和画布上的参考图、生成节点、资产库连成一条流水线。
BYOK:模型服务自己挑
脚本节点本身不绑定任何模型。生成发生在画布的图像、视频、音频节点上,而这些节点用哪个模型,由你在配置里自己决定:
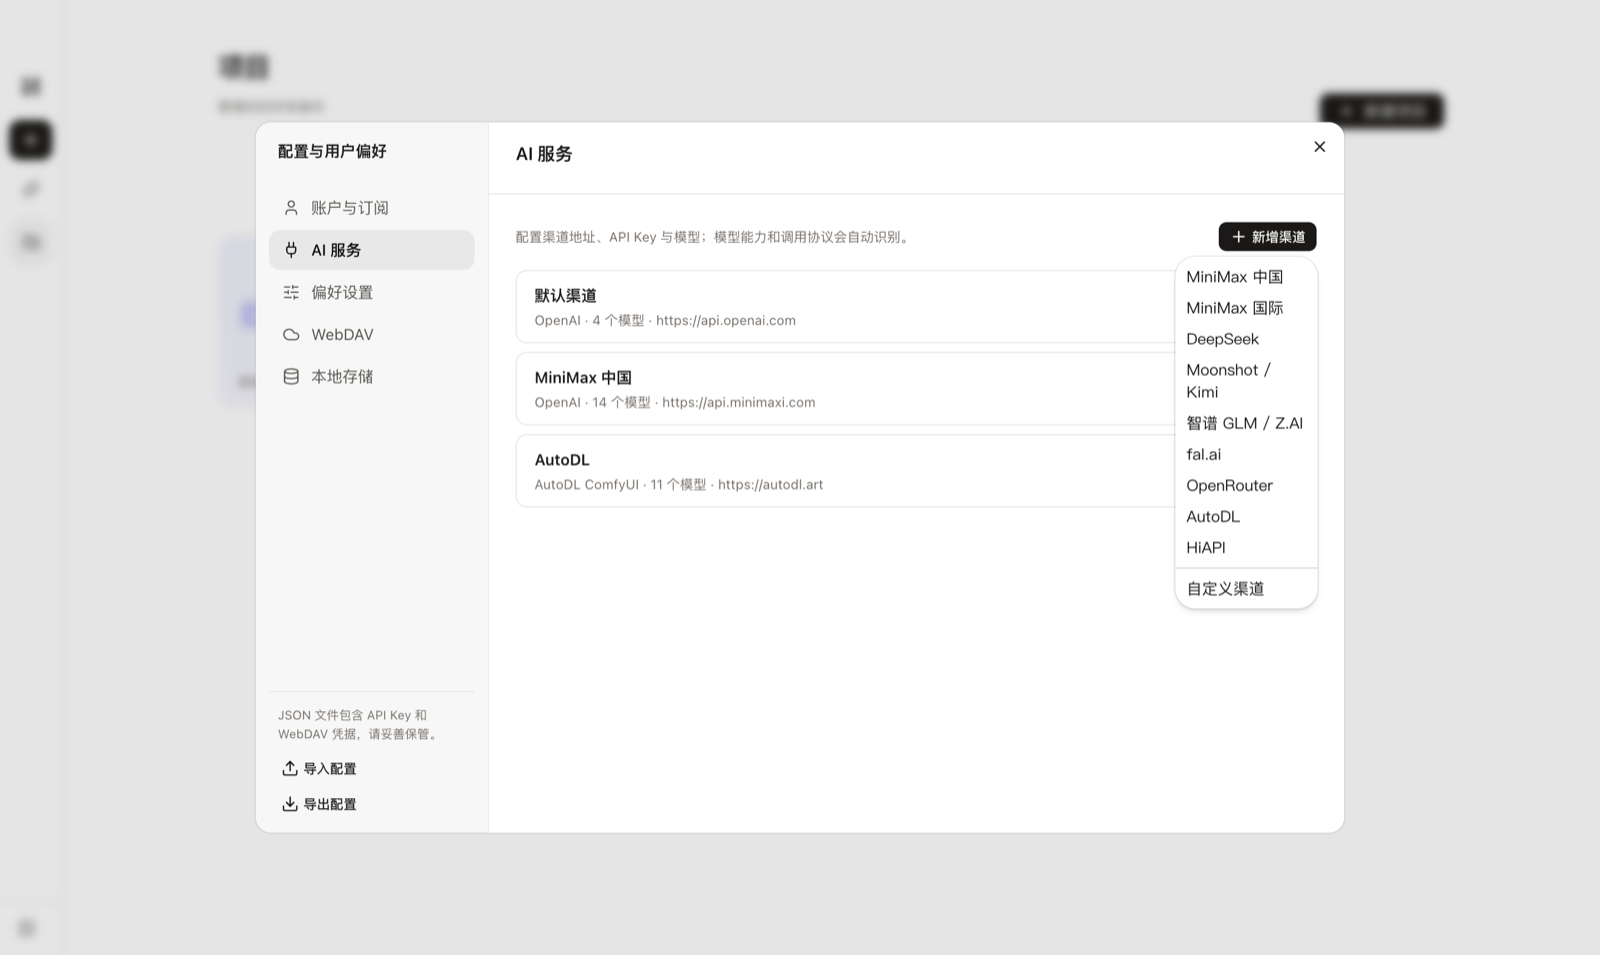
- 渠道预设:新增渠道时内置 OpenRouter、fal.ai、DeepSeek、Moonshot/Kimi、智谱 GLM/Z.AI、MiniMax(中国/国际)、AutoDL、HiAPI 预设,Base URL 自动填好;任何 OpenAI 或 Gemini 兼容接口也能加为自定义渠道。
- 按能力分模型:文本、图像、视频、音频、Agent 五类能力可分别指定不同渠道的模型——比如文本和 Agent 走 OpenRouter 上的推理模型,图像走 fal.ai,视频走你自建的推理服务。
- 账单透明:所有请求从前端直接发往你配置的服务地址,用量和费用都在你自己的服务商账户里,没有平台加价和积分池。
这条设计和本地优先是一体的:API Key、项目、素材都在你设备上,只有触发生成的那一步,提示词与参考素材才会发往你指定的模型服务。
诚实的建议:这不是「谁取代谁」
- 选 LibTV 这类云端平台:纯叙事内容(短剧、动画短片)、需要平台内模型生态和模板化流水线、对数据驻留不敏感的团队。
- 选 Shotshot:分镜服务于具体产品(电商、众筹、新品发布),手上有 3D 模型或产品图资产,想用自己的模型组合与 key,或者产品未上市、素材不能出本机。
- 混用:叙事骨架在云端平台快速试,产品向成片回到本地精细控——分镜数据结构是通的,来回搬不难。
开始你的第一条分镜
安装与系统要求见下载页;配置渠道时准备好你的 OpenRouter 或 fal.ai API Key 即可,两分钟填完。
如果你也在做产品视频的分镜前期,欢迎下载 Shotshot 桌面版试一条:从一句话到可批量出片的分镜脚本,大约就是喝杯咖啡的时间。